单机推理提供极简部署体验,用户仅需在部署页面填写模型部署的镜像、资源规格、端口号等必填字段,即可快速启动一个独立推理服务并获取API服务调用地址。该模块适用于快速验证模型效果或轻量级API发布场景,无需关注应用编排细节,实现模型即服务(Model-as-a-Service)的一键交付。
操作步骤
部署单机推理服务
1、注册并登录平台,打开在线推理——>单机推理模块;
2、点击页面左上角部署按钮,打开服务部署页面;
3、在服务部署页面填写相关参数,具体参数如下:
| 参数名称 | 参数描述 |
| 服务名称 |
|
| 资源类型(选择资源池) |
|
| 实例数 |
|
| 实例规格 |
|
| 共享内存 |
|
| 镜像选择 | 支持四种选择镜像的方式:
|
| 端口号 |
|
| 网关配置 |
|
| 启动命令 |
|
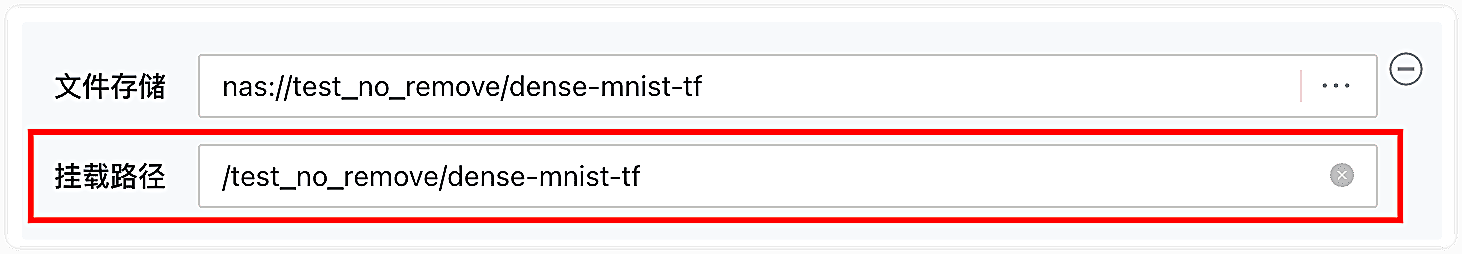
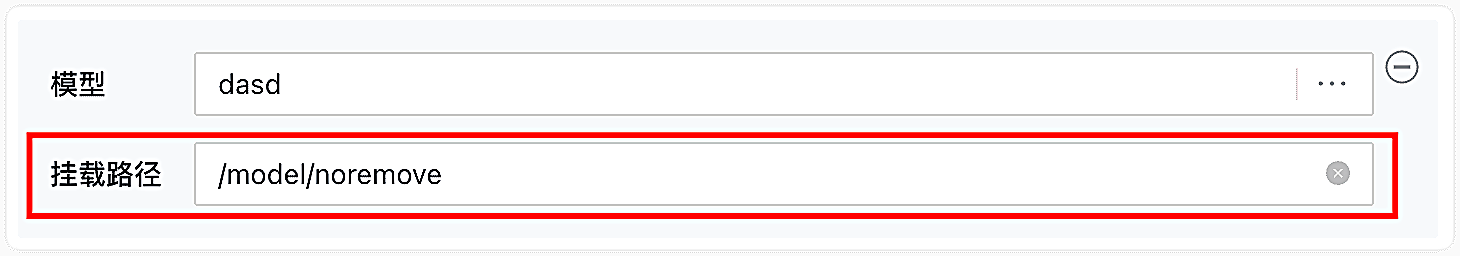
| 选择模型 |
 |
| 环境变量 |
|
| 单次部署失败最大重试次数 |
|
| API认证 |
|
| 最长等待时间 |
|
| Serverless |
 |
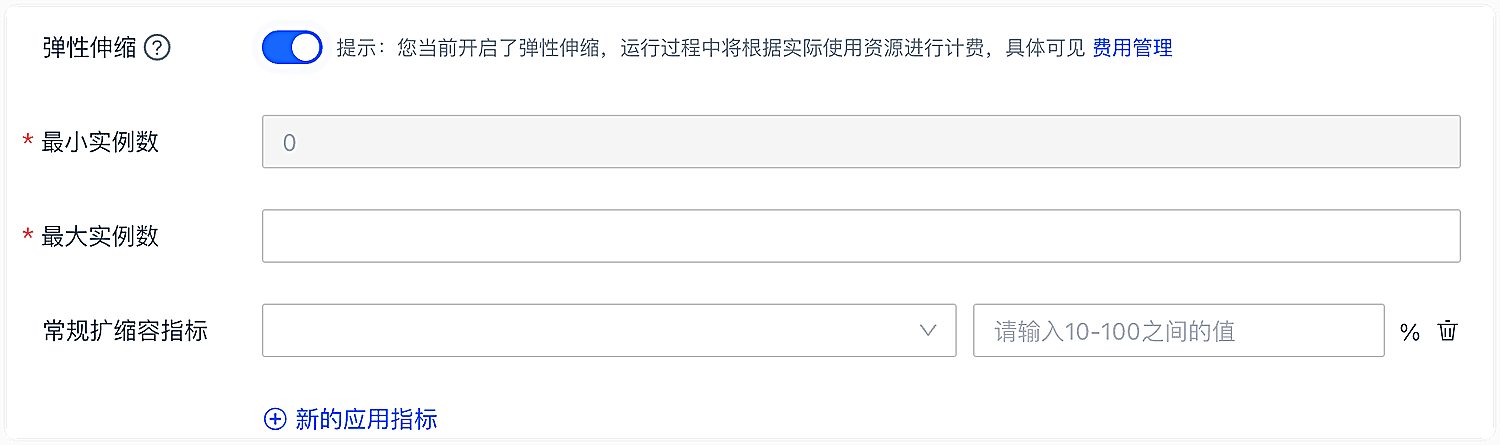
| 弹性伸缩 |
 |
| 代码配置 |
|
信息确认后,点击确认按钮,系统将进行单机推理服务的部署启动。
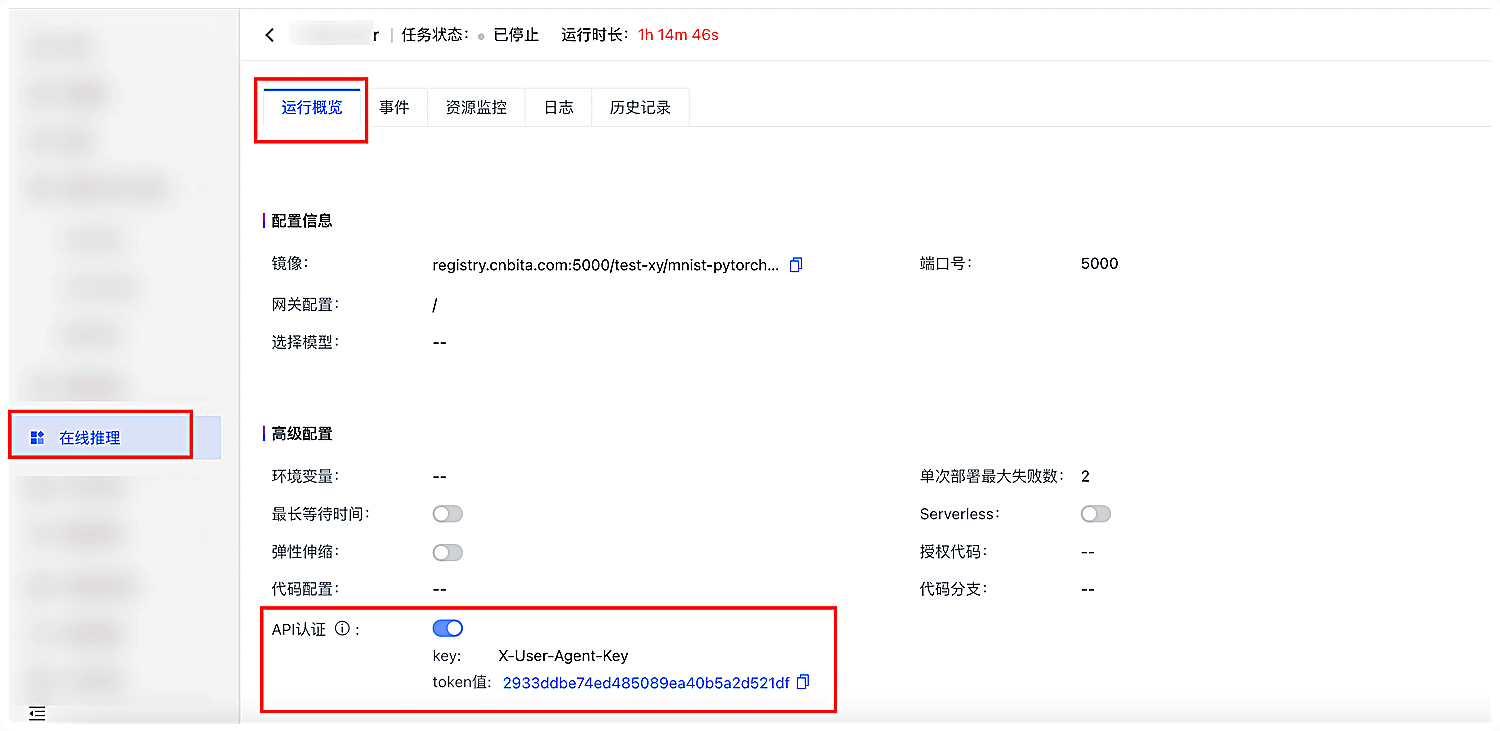
API认证
- 用户创建推理服务,开启API认证后,可在服务详情页——>基础信息查看服务信息,可通过接口请求工具进行接口访问。如postman,key和token值塞进header里
serverless
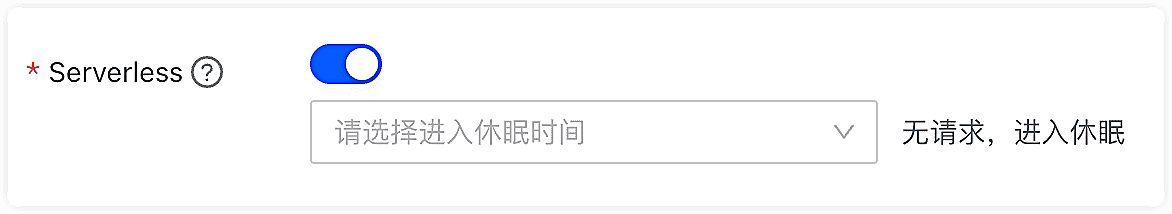
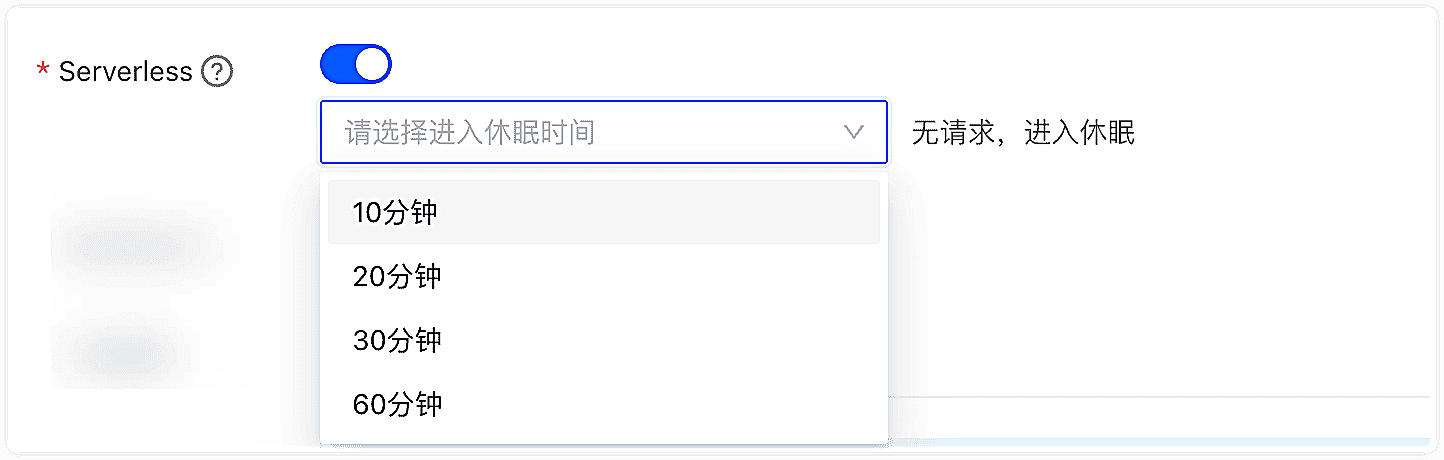
Serverless 即支持副本数为0,是一种云计算架构模式,用户无需关心服务器的管理、维护和扩展,只需将服务部署好,平台将根据服务的访问情况动态进行资源分配、自动扩展,确保闲忙时期的资源和用户访问合理分配。使用该功能时有以下注意事项:
- 在服务部署页面的高级配置模块打开支持副本数为0的开关;
- 支持用户自定义空闲时间,范围为10-60分钟;空闲时间是指当前部署在设置时间范围内无请求流量,超出则平台进行副本为0处理;
- 副本缩为0后,系统将不会对服务进行收费;
- 当缩为0后用户再请求时,响应时间会受网络、模型大小等影响而变化,建议副本缩为0后,用户首次请求启动服务时进行服务激活再进行正式请求,以防请求丢失;
弹性伸缩
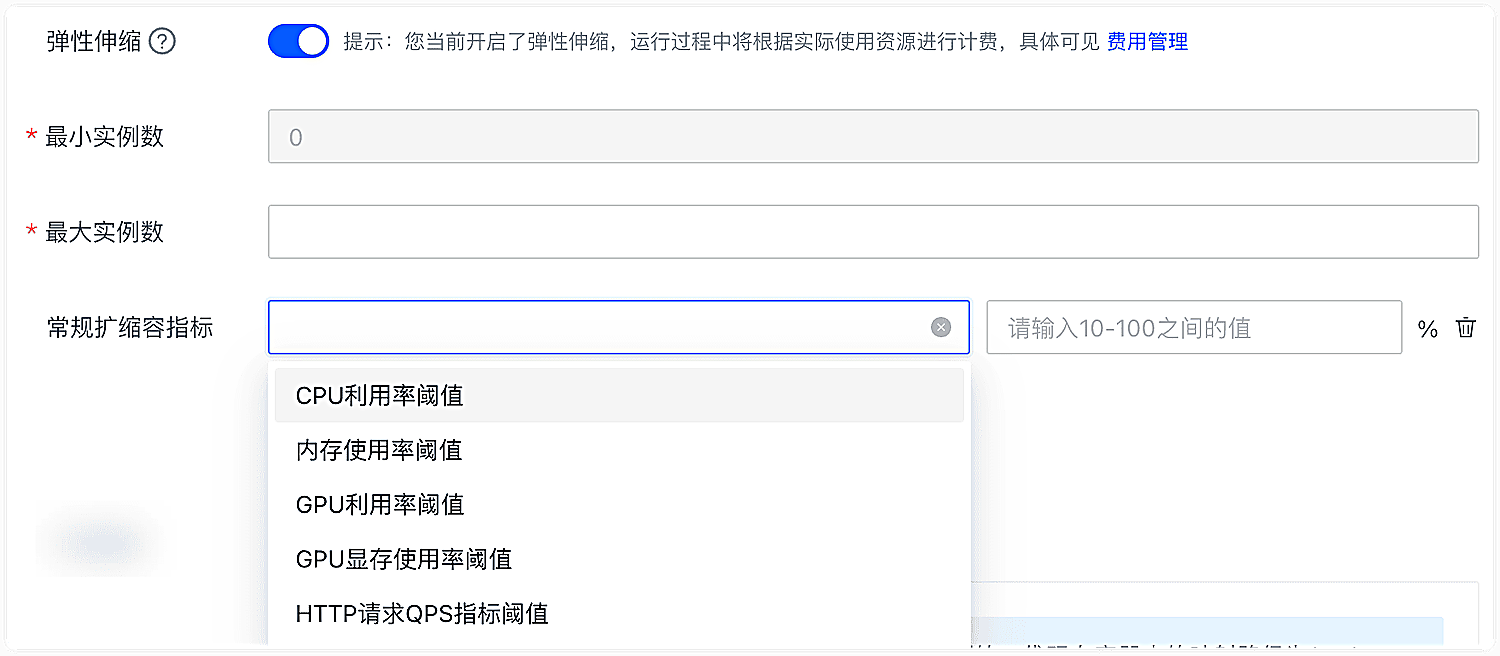
弹性伸缩允许用户根据应用程序的负载情况自动增加或减少 Pod 的数量,以确保应用程序的性能和可用性。通过自动监控应用程序的负载度量指标,并根据负载情况自动增加或减少 Pod 的数量,以满足应用程序的性能和可用性要求。这样可以更好地应对流量波动和负载变化,同时提高集群资源利用率。使用该功能时有以下注意事项:
- 在服务部署页面的高级配置模块打开开启弹性伸缩的开关;
- 用户可按需配置扩缩容指标和实例范围,如果只开启弹性伸缩没开启serverless,则实例范围为1-100,如果开启了serverless,则则实例范围为0-100;
- 平台将根据用户对服务的请求情况以及资源使用情况动态实现实例副本的扩缩;
- 每个指标只可设置一次,单个服务最多可设置5组指标,指标间为或关系,满足一条即触发扩缩容;
扩缩容指标包括:
CPU利用率阈值:指标范围为10%-100%,服务运行时资源超出阈值后,将按需进行实例扩充;
内存使用率阈值:指标范围为10%-100%,服务运行时资源超出阈值后,将按需进行实例扩充;
GPU利用率阈值:指标范围为10%-100%,服务运行时资源超出阈值后,将按需进行实例扩充;
GPU显存使用率阈值:指标范围为10%-100%,服务运行时资源超出阈值后,将按需进行实例扩充;
HTTP请求QPS指标阈值:指标范围为20-无上限 次/秒,服务运行时资源超出阈值后,将按需进行实例扩充;