分布式推理是平台面向大规模参数模型(如十亿/百亿级 LLM)提供的高性能部署能力。通过 Master-Worker 架构、节点横向扩展以及 PD(Prefill/Decode)分离模式,用户可快速构建具备 高并发、高吞吐、低时延 的推理服务。
该功能适用于:
- 模型规模较大、单机现存不足的推理任务
- 高并发业务场景,如在线对话、内容生成、信息抽取等
- 对推理延迟敏感,希望通过PD分离提升整体吞吐的业务
- 希望灵活选择vLLM/SGLang等性能框架,获得最佳推理性能
平台已提供可视化配置能力,用户无需了解复杂的分布式部署细节即可完成推理服务搭建。
| Master-Worker 架构的一键式部署 | 无需复杂脚本,快速启动分布式推理集群 |
| 支持标准模式 & PD 分离模式 | 按业务场景灵活优化吞吐(标准)或降低延迟(PD 分离) |
| 多框架支持(vLLM / SGLang / 自定义) | 满足不同模型生态的最佳实践 |
| 节点数、角色配置灵活 | 支持超大规模集群部署 |
| 完善的监控、日志、历史记录 | 清晰定位性能瓶颈与资源用量 |
操作步骤
部署分布式推理服务
1、注册并登录平台,打开在线推理——>分布式推理模块;
2、点击页面左上角部署按钮,打开服务部署页面;
3、在服务部署页面填写相关参数,具体参数如下:
导航名称 | 字段名 | 解释说明 |
基础信息 | 服务名称 |
|
环境配置 | 镜像选择 |
|
网关配置 |
| |
选择模型 |
| |
运行环境 | 资源类型 |
|
推理模式 |
| |
实例配置 |
| |
高级配置 | 环境变量 |
|
| API认证 |
| |
代码配置 |
|
信息确认后,点击确认按钮,系统将进行单机推理服务的部署启动。
推理模式选择
平台当前支持两类分布式推理模式:标准模式与 PD 分离模式。不同模式适用于不同的业务场景,用户可在创建服务时按需选择。
1. 标准模式(Standard Mode)
标准模式采用 Master–Worker 架构,并内置统一路由能力。
-
Master 节点:负责任务调度、集群管理和流量路由。
-
Worker 节点:执行实际的推理计算。
该模式适用于传统的大模型推理部署场景,部署简单且资源利用稳定。
2. PD 分离模式(Prefill–Decode Disaggregation Mode)
PD 分离模式将推理解耦为 Prefill(预填阶段) 与 Decode(解码阶段),并新增 智能路由节点 实现自动流量调度。
-
Prefill 节点:负责处理 Token 生成前的计算密集阶段。
-
Decode 节点:负责 Token 逐步生成过程的轻量化计算。
-
智能路由节点:仅负责流量分发,不参与推理计算。
-
Prefill 与 Decode 均采用 Master–Worker 架构,可分别独立扩缩容。
该模式适用于高并发、长文本生成、吞吐敏感等场景,可显著提升整体服务性能。
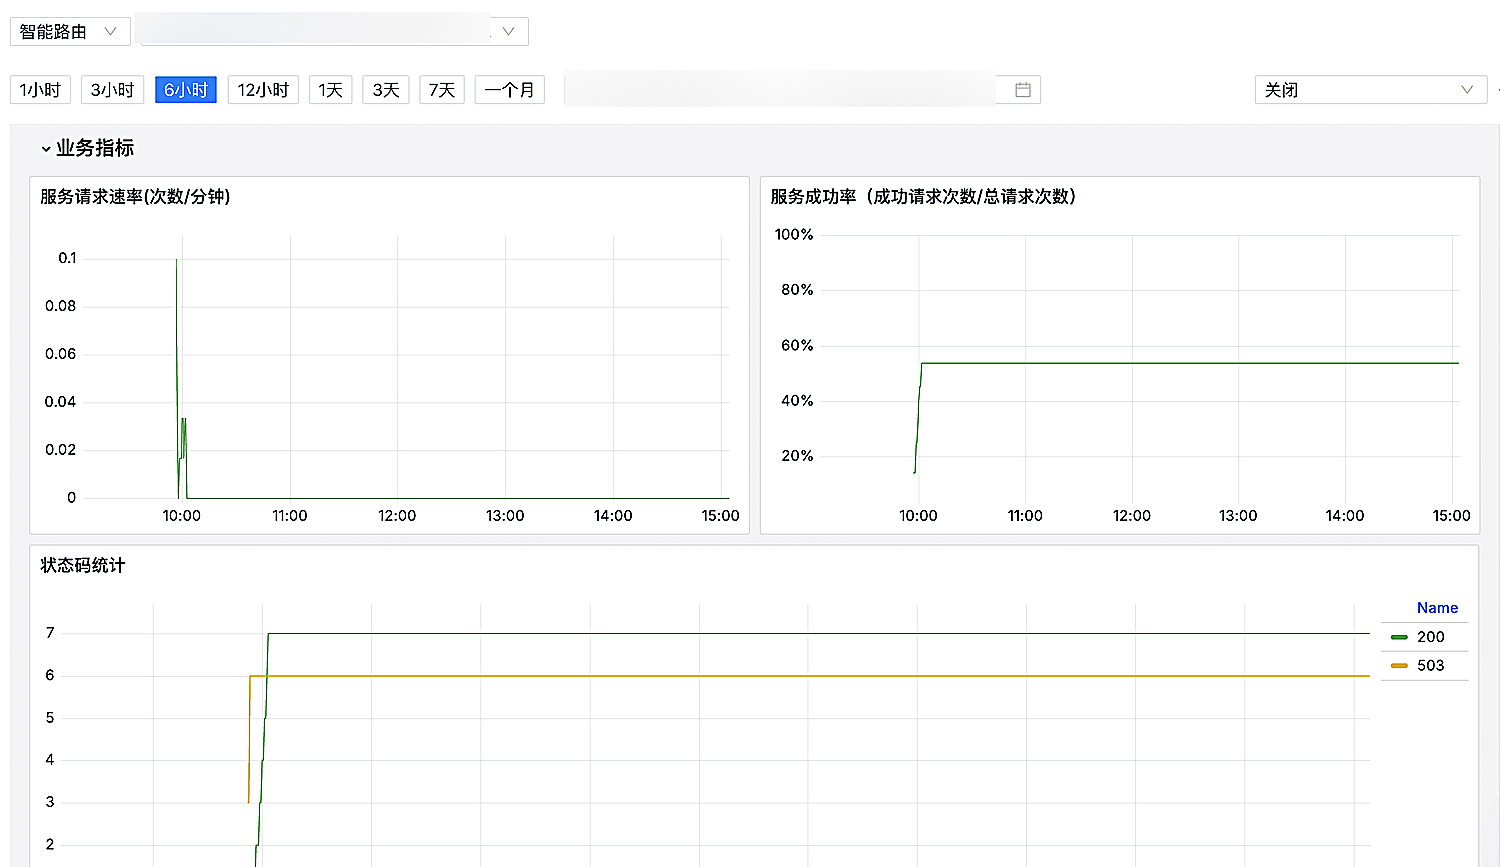
**注:**在推理服务运行中,业务指标数据,可通过「资源监控」中,「智能路由」的业务指标查看